Scheduler 调度器
概念
Scheduler是kubenetes的调度器,主要的任务是把定义的pod分配到集群的节点上。
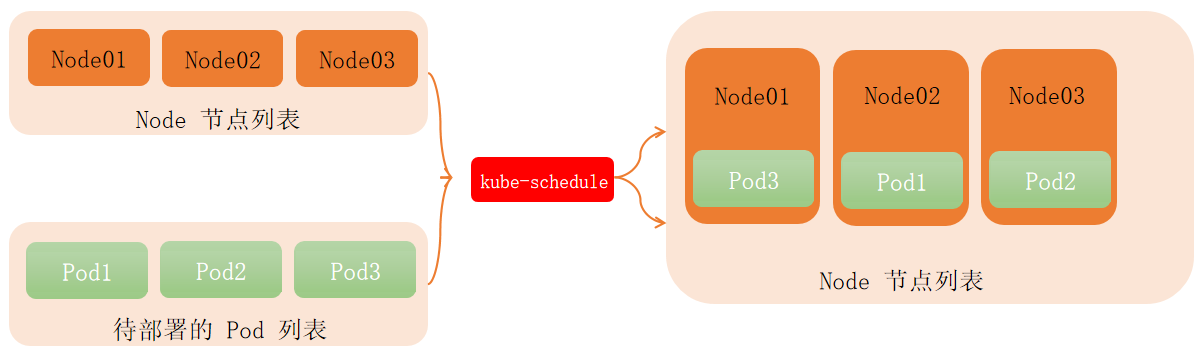
Sheduler 是作为单独的程序运行的,启动之后会一直监听 APIServer,获取 PodSpec.NodeName 为空的 pod,对每个 pod 都会创建一个 binding,表明该 pod 应该放到哪个节点上
概念听起来是非常简单的,但有很多要考虑的问题
- 公平:如何保证每个节点都能被分配资源
- 资源高效利用:集群所有资源最大化被使用
- 效率:调度的性能要好,能够尽快地对大批量的pod完成调度工作
- 灵活:允许用户根据自己的需求控制调度的逻辑
自定义调度器
除了 kubernetes 自带的调度器,你也可以编写白己的调度器。通过 spec:schedulername 参数指定调度器的名字,可以为 pod 选择某个调度器进行调度。比如下面的 pod 选择 my-scheduler 进行调度,而不是默认的 default-scheduler。
my-scheduler
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: myapp
  name: myapp
spec:
  replicas: 1
  selector:
    matchLabels:
      app: myapp
  template:
    metadata:
      labels:
        app: myapp
    spec:
      schedulerName: my-scheduler
      containers:
      - image: wangyanglinux/myapp:v1.0
        name: myapp
过程
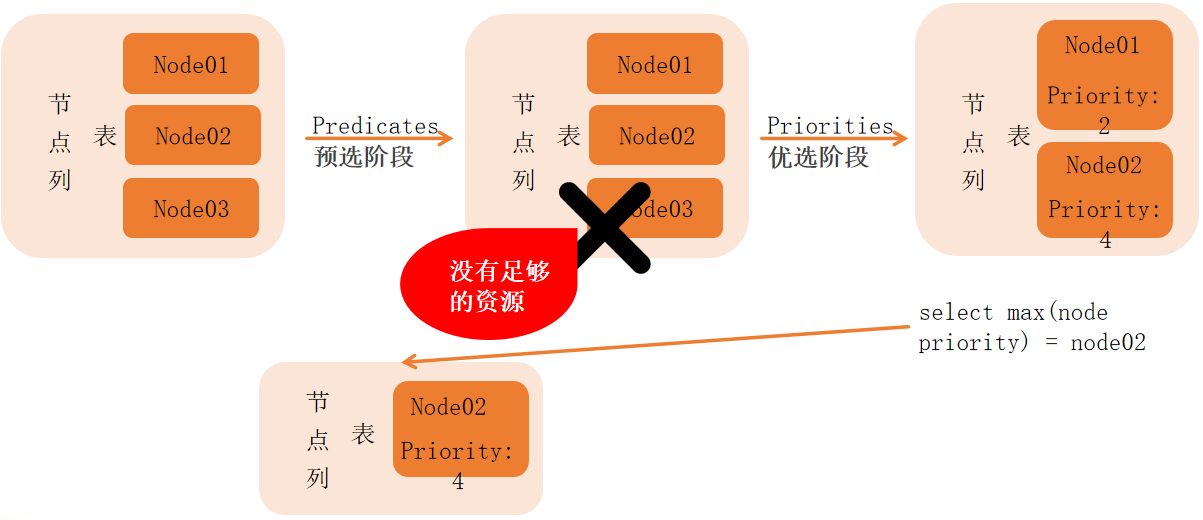
调度分为几个部分:首先是过滤掉不满足条件的节点,这个过程称为 预选;然后对通过的节点按照优先级排序,这个是 优选,最后从中选择优先级最高的节点。如果中间任何一步骤有错误,就直接返回错误。
预选
PodFitsResources:节点上剩余的资源是否大于pod请求的资源PodFitsHost:如果pod指定了NodeName,检查节点名称是否和NodeName匹配PodFitsHostPorts:节点上已经使用的port是否和pod申请的port冲突PodSelectorMatches:过滤掉和pod指定的label不匹配的节点NoDiskConflict:已经mount的volume和pod指定的volume不冲突,除非它们都是只读
优选
如果在预选过程中没有合适的节点,pod 会一直在 pending 状态,不断重试调度,直到有节点满足条件。经过这个步骤,如果有多个节点满足条件,就继续优选过程:按照优先级大小对节点排序
优先级由一系列键值对组成,键是该优先级项的名称,值是它的权重(该项的重要性)。
这些优先级选项包括:
LeastRequestedPriority:通过计算CPU和Memory的使用率来决定权重,使用率越低权重越高。换句话说,这个优先级指标倾向于资源使用比例更低的节点BalancedResourceAllocation:节点上CPU和Memory使用率越接近,权重越高。这个应该和上面的一起使用,不应该单独使用ImageLocalityPriority:倾向于已经有要使用镜像的节点,镜像总大小值越大,权重越高
亲和性
pod.spec.nodeAffinity
preferredDuringSchedulingIgnoredDuringExecution:软性策略requiredDuringSchedulingIgnoredDuringExecution硬性策略
节点亲和性 - 软策略
preferredDuringSchedulingIgnoredDuringExecution
apiVersion: v1
kind: Pod
metadata:
  name: node-affinity-preferred
  labels:
    app: node-affinity-preferred
spec:
  containers:
  - name: node-affinity-preferred-pod
    image: wangyanglinux/myapp:v1.0
  affinity:
    nodeAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 1
        preference:
          matchExpressions:
          - key: domain
            operator: In
            values:
            - xinxianghf
节点亲和性 - 硬策略
requiredDuringSchedulingIgnoredDuringExecution
apiVersion: v1
kind: Pod
metadata:
  name: node-affinity-required
  labels:
    app: node-affinity-required
spec:
  containers:
  - name: node-affinity-required-pod
    image: wangyanglinux/myapp:v1.0
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: kubernetes.io/hostname
            operator: In
            values:
            - k8s-node04
pod.spec.podAffinity/podAntiAffinity
preferredDuringSchedulingIgnoredDuringExecution:软性策略requiredDuringSchedulingIgnoredDuringExecution:硬性策略
Pod 亲和性 - 软策略
preferredDuringSchedulingIgnoredDuringExecution
apiVersion: v1
kind: Pod
metadata:
  name: pod-aff-prefer
  labels:
    app: pod-aff
spec:
  containers:
  - name: myapp
    image: wangyanglinux/myapp:v1.0
  affinity:
    podAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 1
        podAffinityTerm:
          labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values:
              - pod-1
          topologyKey: kubernetes.io/hostname
Pod 亲和性 - 硬策略
requiredDuringSchedulingIgnoredDuringExecution
apiVersion: v1
kind: Pod
metadata:
  name: pod-aff-req
  labels:
    app: pod-aff-req
spec:
  containers:
  - name: pod-aff-req-c
    image: wangyanglinux/myapp:v1.0
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - pod-1
        topologyKey: kubernetes.io/hostname
Pod 反亲和性 - 软策略
preferredDuringSchedulingIgnoredDuringExecution
apiVersion: v1
kind: Pod
metadata:
  name: pod-antiaff-prefer
  labels:
    app: pod-aff
spec:
  containers:
  - name: myapp
    image: wangyanglinux/myapp:v1.0
  affinity:
    podAntiAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 1
        podAffinityTerm:
          labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values:
              - pod-2
          topologyKey: kubernetes.io/hostname
Pod 反亲和性 - 硬策略
requiredDuringSchedulingIgnoredDuringExecution
apiversion: v1
kind: Pod
metadata:
  name: pod-aff-req
  labels:
    app: pod-aff-req
spec:
  Containers:
  - name: pod-aff-req-c
    image: wangyanglinux/myapp:v1.0
  affinity:
    podAntiAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - pod-1
        topologykey: kubernetes.io/hostname
| 调度策略 | 匹配标签 | 操作符 | 拓扑域支持 | 调度目标 |
|---|---|---|---|---|
| nodeAffinity | 主机 | In, NotIn, Exists, DoesNotExists, Gt, Lt | 否 | 指定主机 |
| podAffinity | POD | In, NotIn, Exists, DoesNotExists | 是 | POD与指定POD同一拓扑域 |
| podAntiAffinity | POD | In, NotIn, Exists, DoesNotExists | 是 | POD与指定POD不在同一拓扑域 |
污点和容忍
污点
概念
taint 和 toleration 相互配合,可以用来避免 pod 被分配到不合适的节点上。每个节点上都可以应用一个或多个 taint ,这表示对于那些不能容忍这些 taint 的 pod,是不会被该节点接受的。如果将 toleration 应用于 pod 上,则表示这些 pod 可以(但不要求)被调度到具有匹配 taint 的节点上。
组成
key=value:effect
- 每个污点有一个
key和value作为污点的标签,其中value可以为空,effect描述污点的作用。当前tainteffect支持如下三个选项:NoSchedule:表示k8s将不会将Pod调度到具有该污点的Node上PreferNoSchedule:表示k8s将尽量避免将Pod调度到具有该污点的Node上NoExecute:表示k8s将不会将Pod调度到具有该污点的Node上,同时会将Node上已经存在的Pod驱逐出去
容忍
概念
设置了污点的 Node 将根据 taint 的 effect: NoSchedule、PreferNoSchedule、NoExecute 和 Pod 之间产生互的关系,Pod 将在一定程度上不会被调度到 Node 上。但我们可以在 Pod 上设置容忍(Toleration),意思是设置了容忍的 Pod 将可以容忍污点的存在,可以被调度到存在污点的 Node 上。
设置方式
tolerations:
- key: "key1"
  operator: "Equal"
  value: "value1"
  effect: "NoSchedule"

tolerations:
- key: "key1"
  operator: "Equal"
  value: "value1"
  effect: "NoSchedule"
  tolerationSeconds: 3600
特殊类型
- 当不指定
value时,表示容忍所有的污点value:
tolerations:
- key: "key2"
  operator: "Equal"
  effect: "NoSchedule"
- 当不指定
key时,表示容忍所有的污点key:
tolerations:
  operator: "Exists"
- 当不指定
effect时,表示容忍所有的污点作用:
tolerations:
- key: "key"
  operator: "Exists"
- 有多个
Master时,防止资源浪费,可以进行如下设置:
$ kubectl taint node nodeName node-role.kubernetes.io/master=:PreferNoSchedule
固定节点调度
pod.spec.nodeName: 将Pod直接调度到指定的Node节点上,会跳过Scheduler的调度策略,该匹配规则是强制匹配
pod.spec.nodeName
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nodename-test
spec:
  replicas: 7
  selector:
    matchLabels:
      app: nodename
  template:
    metadata:
      labels:
        app: nodename
    spec:
      nodeName: k8s-node01
      containers:
      - name: myweb
        image: wangyanglinux/myapp:v1.0
        ports:
        - containerPort: 80
pod.spec.nodeSelector:通过kubernetes的label-selector机制选择节点,由调度器调度策略匹配label,而后调度Pod到目标节点,该匹配规则属于强制约束
pod.spec.nodeSelector
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nodeselect-test
spec:
  replicas: 2
  selector:
    matchLabels:
      app: nodeselect
  template:
    metadata:
      labels:
        app: nodeselect
    spec:
      nodeSelector:
        type: nodeselect
      containers:
      - name: myweb
        image: wangyanglinux/myapp:v1.0
        ports:
        - containerPort: 80
pod.spec.nodeName 可以跳过污点,pod.spec.nodeSelector 不可以跳过污点。